

Einleitung
Generative KI gehört inzwischen für viele zum Studienalltag. Aus Sicht der Dozierenden am Lehrstuhl für Medieninformatik ist es wichtig, dass Sie den Umgang mit diesen Werkzeugen lernen und genügend Freiraum zum Ausprobieren haben. Zugleich dürfen dabei die Kompetenzen nicht verloren gehen, die den Kern des Medieninformatikstudiums ausmachen — das Programmieren ebenso wie das wissenschaftliche Arbeiten. Unter generativer „KI“ verstehen wir im Folgenden Werkzeuge, die auf großen Sprachmodellen (Large Language Models, LLMs) basieren, beispielsweise ChatGPT oder Claude.
Die vorliegende KI-Richtlinie beschreibt, wie wir an unserem Lehrstuhl damit umgehen wollen. Verbindliche Regeln für konkrete Abgaben werden zukünftig in allen Kursen kommuniziert. Diese Handreichung gilt für die übrigen Fälle, die im jeweiligen Kurs nicht anders festgelegt werden. Ziel der Richtlinie ist es, einen transparenten und nachvollziehbaren Rahmen für den Einsatz generativer KI zu schaffen. Sie soll Studierenden Orientierung bieten und zugleich ausreichend Flexibilität für die unterschiedlichen Anforderungen unserer Lehrveranstaltungen erhalten.
Im Folgenden finden Sie fünf allgemeine Grundsätze, danach neun Anwendungsfelder mit konkreten Kursregelungen und Hinweise zur korrekten Angabe der KI-Nutzung.
Fünf Grundsätze
- Die Kursregeln haben Vorrang. Für jede Lehrveranstaltung stellen die Dozierenden zu Beginn die gültigen Kursregeln vor und kommunizieren sie via GRIPS. Werden keine Kursregeln kommuniziert gilt diese Handreichung. Sind Sie unsicher, fragen Sie vor der Abgabe nach.
- Sie sind für Ihre Abgaben verantwortlich. Sie müssen jeden Absatz und jede Zeile Code, die Sie einreichen, verstehen und auf Nachfrage erklären können. Das ist der eigentliche Maßstab — nicht, ob ein Modell beteiligt war.
- Wahrheitsgemäße Angaben schützen Sie. Eine wahrheitsgemäße Angabe der KI-Nutzung ist Teil guter wissenschaftlicher Praxis. Die Nutzung von LLMs ohne Angabe kann unter Umständen als Unterschleif gewertet werden und zum Nichtbestehen von Leistungen führen.
- Datenschutz. Unabhängig vom Anwendungsfeld müssen Datenschutz, Urheberrecht und Lizenzen beachtet werden. Laden Sie keine personenbezogenen, vertraulichen oder anderweitig geschützten Daten in externe KI-Dienste hoch, wenn Sie dazu nicht berechtigt sind. Bei Forschungsdaten klären Sie vor dem Upload, ob die Nutzung des jeweiligen Dienstes zulässig ist.
- Freiwilligkeit und Gleichberechtigung. Sie sollen im Studium möglichst viel lernen. Auch gibt es berechtigte ethische und rechtliche Bedenken gegenüber der Nutzung von LLMs. Wir fordern daher in Lehrveranstaltungen nie, dass Sie Aufgaben mit LLMs lösen sollen, die sie auch ohne deren Nutzung lösen könnten. Offensichtliche Ausnahmen sind z.B. Lehrveranstaltungen zur LLM-Nutzung. Für die erfolgreiche Teilnahme an unseren Lehrveranstaltung wird darüber hinaus kein kostenpflichtiges KI-Abonnement vorausgesetzt. Die Universität Regensburg stellt ihren Studierenden im Übrigen mit Microsoft Copilot einen zentralen Zugang zu generativer KI zur Verfügung. Ferner können Studierende diverse Sprachmodelle über https://academiccloud.de kostenfrei nutzen.
Nutzungsregeln
Für die folgenden Anwendungsfelder unterscheiden wir vier Stufen der KI-Nutzung:
| Nutzungsregeln | Erklärung |
|---|---|
| Ohne Angabe erlaubt | Die Nutzung ist grundsätzlich zulässig und muss nicht eigens dokumentiert werden. |
| Mit Angabe erlaubt | Die Nutzung ist grundsätzlich zulässig, muss aber in der Arbeit offengelegt werden. |
| Nur mit ausdrücklicher Erlaubnis | Die Nutzung ist nur zulässig, wenn sie in der jeweiligen Lehrveranstaltung ausdrücklich erlaubt wurde. |
| Nie | Diese Nutzung ist mit den Grundsätzen der Handreichung nicht vereinbar. |
Empfehlungen zur Angabe
Sofern in Lehrveranstaltungen nichts anderes festgelegt ist, reicht eine kurze, nachvollziehbare Dokumentation. Nennen Sie:
das verwendete Werkzeug oder Modell,
den Zweck der Nutzung,
die betroffenen Arbeitsschritte oder Teile der Arbeit,
was die KI dabei konkret beigetragen hat.
Vollständige Chatverläufe oder einzelne Prompts müssen Sie nur dokumentieren oder einreichen, wenn dies in der jeweiligen Lehrveranstaltung ausdrücklich verlangt wird.
Beispiele:
„Bei der Erstellung dieser Arbeit wurde ChatGPT zur Entwicklung von Suchbegriffen für die Literaturrecherche und zur sprachlichen Überarbeitung einzelner selbst verfasster Textabschnitte eingesetzt.“
„Bei der Entwicklung der Anwendung wurde Microsoft Copilot zur Erstellung eines Grundgerüsts für die REST-API sowie zur Fehlersuche bei der Implementierung der Authentifizierung eingesetzt. Der erzeugte Code wurde überprüft, angepasst und in die bestehende Anwendung integriert.“
Im Zweifel
Fragen Sie vor der Abgabe nach. Die Kursregeln bzw. die Anforderungen der Gutachter:innen Ihrer Abschlussarbeit haben Vorrang. Eine offene und wahrheitsgemäße Angabe der KI-Nutzung wird erwartet. Der Versuch, eine Nutzung zu verschleiern, widerspricht den Grundsätzen dieser Richtlinie.
Die folgenden neun Felder regeln typische Formen der KI-Nutzung. Wenn eine Nutzung in mehrere Felder fällt, gelten die jeweils strengeren Regeln.
Anwendungsfelder
1. Lernhilfe
Worum geht es.
Das eigene Lernen mit einem Modell unterstützen: Vorlesungsfolien zusammenfassen, sich Inhalte erklären lassen, Übungsfragen und Quizze zur Prüfungsvorbereitung erzeugen. Abzugrenzen von „Texte lesen und zusammenfassen“, wobei es um wissenschaftliche Texte im Rahmen des wissenschaftlichen Arbeitens geht.
Was uns wichtig ist.
Modelle sind hier eine sehr gute Ergänzung. Behalten Sie aber im Blick, dass das eigene Zusammenfassen selbst ein Teil des Lernens ist: Der Aufwand, einen Foliensatz zu ordnen und in eigene Worte zu fassen, ist nicht die Vorstufe des Verstehens, sondern das Verstehen. Wer das auslagert, wird schneller fertig, lernt dabei aber weniger.
Regeln
Ohne Angabe erlaubt: alles in diesem Feld.
Unabhängig davon: Was ausschließlich dem eigenen Lernen dient, geht nicht in eine Arbeit ein und wird deshalb nicht geregelt. Was daraus in eine Arbeit übernommen wird, fällt unter das entsprechende Anwendungsfeld.
Beispiel zur Angabe: Hier nicht sinnvoll.
2. Brainstorming und Sparringpartner
Worum es geht.
Ideen mit einem Modell entwickeln und durchsprechen: Optionen sammeln, Varianten durchspielen, hinterfragen lassen, warum eine Entscheidung so und nicht anders ausfällt. Abzugrenzen von der „Studien- und Forschungsplanung“, bei der Entscheidungen getroffen werden.
Was uns wichtig ist.
Ideen mit jemandem durchzusprechen, ist fast immer sinnvoll, und Modelle können das in vielen Situationen gut übernehmen. Sie neigen allerdings dazu, der eigenen Position zuzustimmen, und bestätigen dann auch schwache Ideen (Stichwort „Sycophancy (externer Link, öffnet neues Fenster)“). Ein Modell kann deshalb hin und wieder das Gegenüber sein, aber nicht dauerhaft den Menschen ersetzen. Sprechen Sie Ihre Ideen auch mit Kommilitoninnen und Kommilitonen oder Betreuerinnen und Betreuern durch. Wer direkt mit Vorschlägen eines LLM startet, übernimmt leicht bestehende Denkmuster und Lösungswege. Entwickeln Sie daher zunächst eigene Ideen und nutzen Sie das Modell erst anschließend zur Erweiterung und Reflexion.
Regeln
Ohne Angabe erlaubt: die Nutzung als Sparringpartner beim Entwickeln und Durchsprechen von Ideen.
Unabhängig davon: Die Entwicklung von Ideen ist in diesem Bereich geregelt. Sobald daraus Inhalte für eine Arbeit entstehen, gelten die Kursregelungen des jeweiligen Einsatzbereichs, etwa Programmieren, Texte schreiben oder Literaturrecherche.
Differenzierung: Keine. Die Kursregelung gilt in allen Studienabschnitten gleichermaßen.
Beispiel zur Angabe: Hier nicht nötig.
3. Literaturrecherche
Worum es geht.
Literatur mit einem Modell finden und einordnen: von der Suche über Deep-Research-Funktionen bis zum Durchsuchen eigener Dokumentsammlungen und der Einschätzung, ob eine Quelle zuverlässig ist. Abzugrenzen von „Texte lesen und zusammenfassen“, wobei es um das Erschließen der gefundenen Texte geht.
Was uns wichtig ist.
Suchen und Sortieren funktionieren mit Modellen gut, aber das Sichten von Literatur ist genau die Übung, aus der ein Überblick entsteht: Was Sie aussortieren, prägt Ihr Bild des Feldes ebenso wie das, was Sie behalten. Deshalb sollten Sie nicht ausschließlich LLMs zur Literaturrecherche nutzen. Zwei Dinge bleiben darüber hinaus Ihre Aufgabe: Modelle erfinden Quellen oder angebliche Inhalte in existierenden Quellen — jede relevante Aussage ist am Original zu prüfen. Und Sie sehen nicht, worauf ein Modell nicht zugreift; ob eine Suche in der ACM Digital Library, bei IEEE, in Google Scholar oder der (Uni-) Bibliothek dasselbe ergibt, müssen Sie selbst nachprüfen.
Regeln
Ohne Angabe erlaubt: eine erste Suche, um sich einem Thema zu nähern; das Wiederfinden von Literatur, die Sie bereits kennen.
Mit Angabe erlaubt: Literatur, die über ein Modell gefunden wurde und in der Arbeit genutzt wird.
Unabhängig davon: Beschreiben Sie in schriftlichen Arbeiten kurz, wie Sie gesucht haben — welche Datenbanken, welche Werkzeuge, welche Suchbegriffe. Wie Sie gefundene Texte erschließen, regelt der Abschnitt „Texte lesen und zusammenfassen“.
Differenzierung: In Lehrveranstaltungen, die das Recherchieren selbst prüfen, etwa im Propädeutikum und in Seminaren mit eigenständiger Literaturarbeit, ist der Einsatz enger geregelt.
Beispiel zur Angabe: Für die Literaturrecherche wurde Consensus als Unterstützung bei der Entwicklung von Suchbegriffen und der Identifikation relevanter Publikationen verwendet. Die Recherche konzentrierte sich auf “Grundlagen der Human-Computer Interaction”. Berücksichtigt wurden Treffer aus der ACM Digital Library, ACL Anthology, Google Scholar und arXiv. Alle in der Arbeit verwendeten Quellen wurden im Original gesichtet und geprüft.
4. Texte lesen und zusammenfassen
Worum es geht.
Das Erschließen einzelner wissenschaftlicher Texte: zusammenfassen, erklären lassen, mit einem Text chatten (RAG-gestützte Werkzeuge).
Was uns wichtig ist.
Das Lesen und Erschließen von Texten ist eine zentrale Kompetenz der universitären Ausbildung und benötigt Übung. Wissenschaftliche Texte unseres Fachgebiets sind systematisch aufgebaut: Wer diese Struktur kennt, erfasst ihre Inhalte nach einiger Übung schnell und vollständig. Selbstständiges Lesen ist Teil der eigenen Forschungsleistung und lässt sich nicht an ein Modell auslagern. Dass Modelle gute Zusammenfassungen schreiben, ändert daran nichts.
Regeln
Ohne Angabe erlaubt: Werkzeuge zum Wiederfinden bereits gelesener Texte; Zusammenfassungen für die eigenen Notizen.
Mit Angabe erlaubt: KI-gestütztes Erschließen (Zusammenfassungen, Erklärungen, Übersetzungen oder Rückfragen zum Inhalt) von Texten, die Sie in der Arbeit zitieren — vorausgesetzt, Sie haben das Original gelesen.
Nur mit ausdrücklicher Erlaubnis in Lehrveranstaltungen: aus KI-Zusammenfassungen Textteile für das Related Work erzeugen.
Nie: eine KI-Zusammenfassung ungeprüft als eigenen Text übernehmen.
Differenzierung: Wie beim Schreiben gilt: Je stärker das Erschließen von Literatur selbst Prüfungsgegenstand ist, desto enger die Regel. In den ersten Semestern und in Veranstaltungen, die wissenschaftliches Arbeiten einführen, gilt im Zweifel: selbst lesen. In späteren Semestern kann der Einsatz je nach Lehrveranstaltung erlaubt sein.
Beispiel zur Angabe: „Für das Verständnis des Papers „Attention is all you need“ wurde ChatGPT genutzt, um zentrale Konzepte zu erläutern und Verständnisfragen zum Text zu beantworten. Die Originalquelle wurde vollständig gelesen und die KI ausschließlich als Unterstützung beim Erschließen des Textes verwendet.“
5. Studien- und Forschungsplanung
Worum es geht.
Die Planung eigener Studien: Forschungsfrage, Studiendesign, Methodenwahl und Auswertungsstrategie mit einem Modell durchsprechen und entwickeln. Abzugrenzen vom „Brainstorming“, bei dem Ideen gesammelt werden.
Was uns wichtig ist.
Von einer vagen Idee zu einer sinnvollen Forschungsfrage zu gelangen, gelingt selten in einer Frage und einer Antwort. Es ist ein Prozess über viele Schritte, und Modelle können ihn gut begleiten — ersetzen können sie ihn nicht. Die eigentliche Gefahr liegt nicht im Modell, sondern in der ausbleibenden Betreuung: Wer sich früh vom Modell bestätigen lässt, holt kein Feedback mehr ein und beginnt die Erhebung mit einem Design, das niemand geprüft hat. Eine schlecht geplante Studie lässt sich nachträglich nicht reparieren. Suchen Sie deshalb frühzeitig das Gespräch mit Betreuerinnen und Betreuern. KI-Modelle können helfen, Ideen zu entwickeln und zu strukturieren (siehe oben), ersetzen aber nicht das fachliche Feedback und die Erfahrung von Lehrenden.
Regeln
Ohne Angabe erlaubt: entfällt. Jede Unterstützung in diesem Feld ist anzugeben.
Mit Angabe erlaubt: Unterstützung bei der Präzisierung und Weiterentwicklung einer eigenen Forschungsidee, etwa bei der Schärfung einer Forschungsfrage, der Reflexion von Studiendesigns, der Diskussion möglicher Methoden oder der Planung von Auswertungsstrategien.
Nie: Die Entwicklung von Forschungsfrage, Studiendesign oder Auswertung vollständig an ein Modell auslagern. Ausgangspunkt wissenschaftlicher Arbeiten sollte stets eine eigene Fragestellung und ein eigenes Erkenntnisinteresse sein.
Unabhängig davon: Forschungsfrage und Design werden vor der Durchführung mit der betreuenden Person besprochen.
Differenzierung: In Methodenveranstaltungen und Abschlussarbeiten, in denen das Planen einer Studie selbst geprüft wird, ist der Einsatz strenger geregelt.
Beispiel zur Angabe: Für die Studienplanung wurde Gemini verwendet, um mögliche Erhebungsmethoden für die bereits formulierte Forschungsfrage zu diskutieren. Darüber hinaus wurde das Modell genutzt, um potenzielle Störfaktoren zu identifizieren und Vor- und Nachteile verschiedener Auswertungsstrategien gegenüberzustellen. Die Forschungsfrage wurde eigenständig entwickelt und das Studiendesign mit der betreuenden Person abgestimmt.
6. Texte schreiben
Worum es geht.
Das Formulieren von zusammenhängendem Text: einzelne Sätze, Absätze, ganze Kapitelentwürfe. Nicht gemeint ist die Überarbeitung von Text, den Sie selbst geschrieben haben, siehe „Texte überarbeiten“.
Was uns wichtig ist.
Schreiben ist eine zentrale Kompetenz der universitären Ausbildung. Das Ausformulieren der eigenen Gedanken als Text kann nur durch Übung erlernt und verbessert werden. Darüber hinaus werden Gedanken und Argumente beim Schreiben geschärft. Die Auslagerung des Schreibens an ein LLM steht dem entgegen.
Regeln
Ohne Angabe erlaubt: entfällt
Mit Angabe erlaubt: Gliederungsentwürfe und Vorschläge für den Aufbau von Texten.
Nur mit ausdrücklicher Erlaubnis in Lehrveranstaltungen: generierte Absätze oder Textteile, die in die Arbeit eingehen — auch dann, wenn Sie sie anschließend überarbeiten.
Unabhängig davon: Die Überarbeitung bereits geschriebener eigener Texte regelt das Feld „Texte überarbeiten“.
Differenzierung: Je stärker das Schreiben selbst Prüfungsgegenstand ist, desto enger die Regeln. In den ersten Semestern und der Bachelorarbeit gilt im Zweifel: selbst formulieren. Im Master und in einzelnen Veranstaltungen kann mehr erlaubt sein — das wird in den Lehrveranstaltungen kommuniziert.
Beispiel zur Angabe: Zur Erstellung einer ersten Gliederung wurde Claude eingesetzt. Das Modell schlug eine Struktur mit den Abschnitten Einleitung, Related Work, Methodik, Ergebnisse, Diskussion und Fazit vor. Die Inhalte und Formulierungen der einzelnen Abschnitte wurden eigenständig erarbeitet.
7. Texte überarbeiten
Worum es geht.
Die Überarbeitung selbst geschriebener Texte zur Überprüfung von Rechtschreibung und Grammatik. Darüber hinaus: die Nutzung der Modelle zur stilistischen Überarbeitung eigener Texte.
Was uns wichtig ist.
LLMs können sinnvolle Werkzeuge zur Überarbeitung der eigenen Texte, zur Korrektur von Rechtschreibung, Grammatik und Stil sein. Für viele dieser Aufgaben eignen sich auch spezialisierte Schreibwerkzeuge wie Grammarly oder LanguageTool, die in der Regel gezielter auf sprachliche Korrekturen ausgerichtet sind und weniger stark in Inhalt, Argumentation oder Struktur eines Textes eingreifen. Nichtsdestotrotz müssen die Modelle mit Sorgfalt eingesetzt werden, damit die ursprünglichen Ideen im Text und die eigene Handschrift nicht verloren gehen. Oberstes Ziel wissenschaftlichen Schreibens ist eine präzise und effiziente Kommunikation von Wissen. Ein übermäßiger Einsatz von LLMs kann schnell zu einem pseudo-wissenschaftlichen, überladenen Schreibstil führen.
Regeln
Ohne Angabe erlaubt: Korrektur von Rechtschreibung, Grammatik, Zeichensetzung.
Mit Angabe erlaubt: sprachliche Überarbeitung eigener Entwürfe (Erzählfluss, Konsistenz, Kürzen), Übersetzung eigener Texte.
Nur mit ausdrücklicher Erlaubnis in den Lehrveranstaltungen: komplettes Umschreiben ganzer Absätze und Texte.
Differenzierung: Die Grenze zwischen dem Überarbeiten und dem Schreiben von Texten mit LLMs ist fließend. Deshalb gilt auch hier: Je stärker das Schreiben selbst Prüfungsgegenstand ist, desto enger die Regel.
Beispiel für die Angabe: Für die Überarbeitung dieser Abgabe wurde Perplexity verwendet, um selbst verfasste Textabschnitte sprachlich zu verbessern und unnötige Wiederholungen zu reduzieren. Die Inhalte, Argumentationsstruktur und fachlichen Aussagen stammen von den Autor:innen.
8. Programmieren
Worum es geht.
LLM-gestütztes Programmieren in seiner ganzen Bandbreite: dynamische Codevorschläge in der Entwicklungsumgebung (etwa GitHub Copilot), das Generieren von Code im Chat bis hin zum Übergeben ganzer Anforderungen an einen weitgehend autonom arbeitenden Coding-Agenten („Vibe Coding“). Nicht gemeint ist die klassische, wörterbuchbasierte Autovervollständigung, wie Entwicklungsumgebungen sie seit langem anbieten.
Was uns wichtig ist.
Programmieren ist eine Kernkompetenz der Medieninformatik. Die Grundlagen müssen geübt und verstanden werden — gerade dann, wenn künftig weniger Code von Hand entsteht. Wer selbst programmieren kann, beurteilt die Qualität generierten Codes, erkennt Fehler und überarbeitet ihn. Wer es nicht kann, ist auf das Modell angewiesen und merkt nicht, wenn es danebenliegt und kann durch das Modell entstandene Fehler nicht mehr (selbstständig) beheben.
Regeln
Ohne Angabe erlaubt: sich Code erklären lassen; Recherche zu Syntax; Bibliotheken und Fehlermeldungen.
Mit Angabe erlaubt: Codevervollständigung in der Entwicklungsumgebung; Fehlersuche und Log-Analyse; Boilerplate (externer Link, öffnet neues Fenster) (standardisierte Codebausteine) erzeugen; eigene Lösungen gegenprüfen lassen; Lösungswege durchspielen.
Nur mit ausdrücklicher Erlaubnis in den Lehrveranstaltungen: wesentliche Teile einer Lösung generieren lassen sowie der Einsatz autonomer Coding-Agenten.
Nie: Code abgeben, dessen Funktionsweise und dessen Notwendigkeit nicht erklären können.
Differenzierung: Hier liegt der stärkste Unterschied nach Studienabschnitt. In den ersten Semestern ist Programmieren die Grundlagenausbildung: Wer Programmieraufgaben überwiegend von einem Modell lösen lässt, verzichtet auf wichtige Lerngelegenheiten: Probleme analysieren, Lösungswege entwickeln, Fehler finden und die Funktionsweise von Software verstehen. Diese Kompetenzen werden nicht nur für Prüfungen benötigt, sondern bilden die Grundlage für weiterführende Veranstaltungen und viele Tätigkeiten in der Praxis. In späteren Semestern und im Master ist Programmieren häufig Mittel zum Zweck, etwa zur Durchführung einer Studie — dort kann es zulässig sein, den Code vollständig mit einem Modell zu erzeugen, da das Lernziel ein anderes ist.
Beispiel zur Angabe: Für diese Abgabe wurde Copilot mit dem Modell Gemini Flash zur Codevervollständigung sowie ChatGPT zur Analyse von Fehlermeldungen und zur Erstellung standardisierter Codebausteine (Boilerplate) eingesetzt. Der erzeugte Code wurde geprüft, angepasst und in die bestehende Anwendung integriert.
9. Bildgenerierung
Worum es geht.
Die Generierung von Bildern, Illustrationen und Grafiken zur Nutzung in schriftlichen Arbeiten, Anwendungen und Präsentationen.
Was uns wichtig ist.
Die bisherige Erfahrung zeigt, dass generierte Bilder zum Teil keinen Mehrwert bieten. Der Einsatz sollte auf ein sinnvolles Maß beschränkt bleiben. Insbesondere muss immer klar sein, ob es sich um eine Darstellung von realen Szenen/Daten oder um ein Symboldbild handelt. In wissenschaftlichen Arbeiten und Vorträgen dienen Abbildungen primär der Vermittlung der Information, nicht als hübsches Beiwerk. Generierte Bilder, die unsinnige oder überflüssige Details beinhalten lenken von der Kernaussage ab und können beim Betrachter zu falschen Annahmen führen.
Regeln
Ohne Angabe erlaubt: entfällt.
Mit Angabe erlaubt: erzeugte Bilder und Illustrationen.
Nie: Diagramme und Plots als Bild erzeugen lassen sowie ganze Foliensätze generieren. Eine Darstellung Ihrer Daten muss aus Ihren Daten entstehen — ein generiertes Diagramm zeigt Zahlen, die es nicht gibt.
Unabhängig davon: Plots aus eigenen Daten mit generiertem Code regelt das Feld „Programmieren“.
Differenzierung: In Veranstaltungen, in denen Gestaltung, Bildbearbeitung oder Medienproduktion selbst Lernziel sind, kann es engere oder weniger starke Einschränkungen geben.
Beispiel zur Angabe: „(generiert mit ChatGPT)“ einfügen in Bildunterschrift oder Fußnote
KI-Richtlinien Baukasten
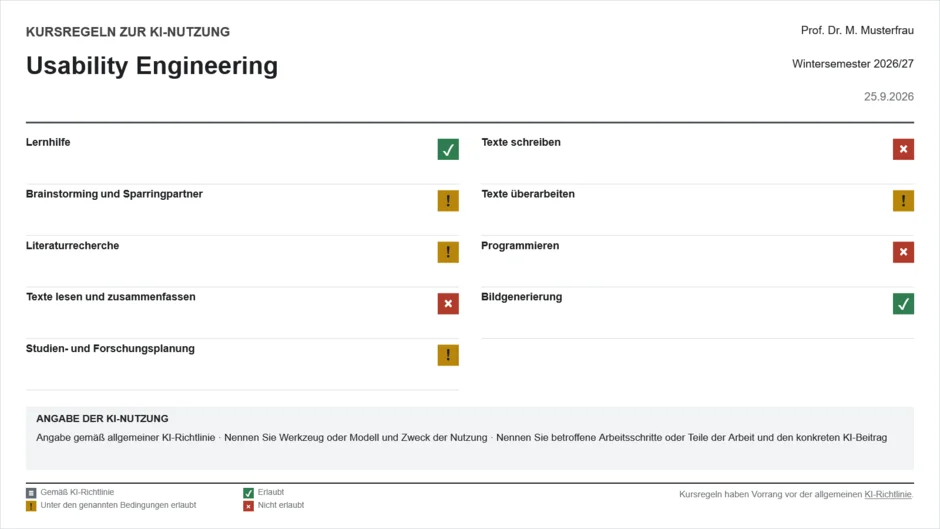
Der KI-Baukasten unterstützt Lehrende dabei, transparente und nachvollziehbare Regelungen für den Einsatz generativer KI in Lehrveranstaltungen zu kommunizieren. Über eine einfache Oberfläche können erlaubte, eingeschränkte und nicht erlaubte Nutzungsformen festgelegt und anschließend als Folie, PowerPoint oder Text exportiert werden.
Die Anwendung wurde am Lehrstuhl für Medieninformatik entwickelt und orientiert sich an typischen Einsatzszenarien generativer KI im Studium, beispielsweise beim Lernen, Programmieren, Schreiben oder Recherchieren.
Verwendung
Mit dem Baukasten können kurs- oder aufgabenspezifische KI-Regelungen erstellt werden. Die ausgewählten Einstellungen werden sofort in einer Vorschau dargestellt und können anschließend als PNG, editierbare PowerPoint-Folie oder Textversion exportiert werden.
Zu den wichtigsten Funktionen gehören:
- Ampelbasierte KI-Regelungen für verschiedene Einsatzbereiche
- Individuell anpassbare Dokumentationsanforderungen
- Live-Vorschau der entstehenden Folie
- Export als PNG, PowerPoint und Text
- Deutsch- und Englisch-Unterstützung
Open Source
Der Quellcode des KI-Baukastens steht als Open-Source-Projekt zur Verfügung und kann an die Anforderungen anderer Lehrveranstaltungen, Studiengänge oder Hochschulen angepasst werden. Weitere Informationen finden sich im Repository und der dort enthaltenen Dokumentation.
Download
- Baukasten: https://michaelachmann.github.io/ki-baukasten/
- GitHub Repository: github.com/michaelachmann/ki-baukasten
Hinweis
Diese Handreichung versteht sich als lebendes Dokument. Da sich generative KI und ihre Einsatzmöglichkeiten kontinuierlich weiterentwickeln, können die Richtlinien regelmäßig angepasst und erweitert werden. Es lohnt sich daher, von Zeit zu Zeit einen Blick auf die aktuelle Version zu werfen.
Die Handreichung wurde auf Grundlage zweier aufeinander aufbauender Veranstaltungen entwickelt. Zunächst wurden in einer Fokusgruppe mit Studierenden Erfahrungen, Wünsche und Herausforderungen im Umgang mit generativer KI gesammelt. Aufbauend auf diesen Ergebnissen erarbeitete das Team des Lehrstuhls für Medieninformatik die vorliegenden Richtlinien in einem gemeinsamen Workshop.
Weitere Ressourcen
- Deutsche Forschungsgemeinschaft. (2019). Leitlinien zur Sicherung guter wissenschaftlicher Praxis. https://doi.org/10.5281/zenodo.3923602
- Ethische Leitlinien zum Einsatz von KI an der Universität Regensburg:
https://www.uni-regensburg.de/universitaet/digitalisierung/leitfaden-zur-nutzung-von-ki/allgemeine-nutzungsrichtlinien-und-hinweise-fuer-den-einsatz-von-generativer-ki-an-der-universitaet-regensburg/ethische-leitlinien-zum-einsatz-von-ki - ACM Policy on Authorship
https://www.acm.org/publications/policies/new-acm-policy-on-authorship